Publicar um arquivo /llms.txt custa poucas horas de trabalho e não expõe o site a nenhum risco técnico real. Por conta disso, o problema acaba não sendo o custo, mas a promessa por trás dele: até agosto de 2026, ainda não temos evidência pública de que Google, ChatGPT, Claude ou Perplexity leiam esse arquivo para decidir o que citar numa resposta de IA.
Highlights
- Um teste de 90 dias da OtterlyAI mediu 62.100 acessos de bots de IA a um site e viu apenas 84 chegarem ao /llms.txt, uma fatia de 0,1% do tráfego de crawlers, abaixo até da média de uma página comum do mesmo domínio.
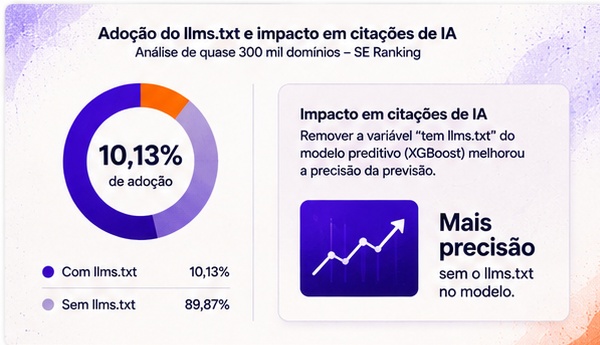
- Uma análise da SE Ranking em quase 300 mil domínios encontrou 10,13% de adoção e nenhuma correlação estatística entre publicar o arquivo e ser citado com mais frequência por modelos de IA; remover essa variável de um modelo preditivo melhorou a precisão dele.
- O criador do padrão, Jeremy Howard, nunca propôs o llms.txt como recurso de SEO ou GEO: a ideia nasceu para ajudar agentes de codificação a consultar documentação técnica sem estourar a janela de contexto do modelo.
- Mesmo sem evidência de impacto em citação, Anthropic, OpenAI e Google publicam seus próprios arquivos llms.txt para documentação de desenvolvedores, e o Chrome já audita a presença do arquivo dentro do Lighthouse, o que ajuda a explicar a confusão em torno do tema.
O que o llms.txt promete resolver
Pra ser bem direto: estamos falando de um arquivo de texto simples, hospedado na raiz do site, ao lado do robots.txt e do sitemap.xml.
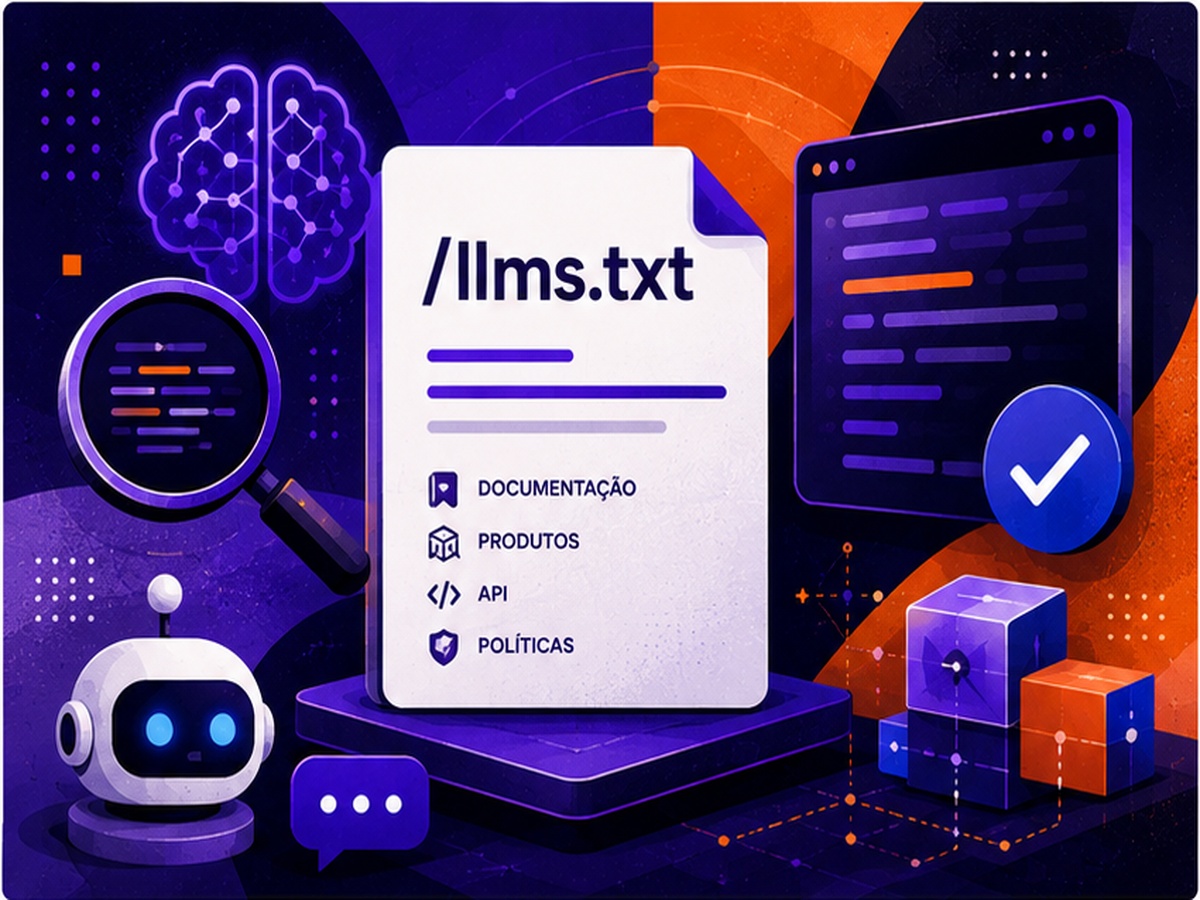
A proposta central do protocolo llms.txt é entregar a modelos de linguagem e agentes de IA uma versão curada e em Markdown do conteúdo mais importante do site, sem o peso de HTML, banner de cookies, menu de navegação e script de rastreamento. Como o próprio texto do padrão explica, o objetivo é resolver um problema técnico específico, como janelas de contexto que ainda são pequenas demais para um site inteiro, e o custo, em tokens, tempo e dinheiro, de transformar HTML bagunçado em texto limpo o suficiente para um modelo raciocinar em cima dele.
Na teoria, ele funciona como um convite direto ao agente. Como se ele disse “aqui está o resumo do que a empresa faz, aqui estão os links para a documentação, os produtos e as políticas mais relevantes, sem precisar adivinhar isso a partir do menu do site.”
De onde veio o padrão e para quem ele foi pensado
O llms.txt surgiu em 3 de setembro de 2024 e foi proposto Jeremy Howard, cofundador da Answer.AI e da fast.ai. A motivação original tinha pouco a ver com marketing de busca. o que o Howard queria era melhorar a experiência de agentes de codificação, como Cursor e Claude Code, consultando documentação técnica de projetos como o FastHTML, seu próprio framework em Python.
Esse detalhe explica boa parte do mal-entendido que se espalhou entre 2025 e 2026. Quando plataformas de documentação passaram a gerar llms.txt automaticamente para clientes como a própria Anthropic, parte da comunidade de SEO e GEO leu aquilo como confirmação de que o arquivo também influenciava a visibilidade de marcas em respostas de IA generativa. O caso de uso original nunca foi esse.
Continua sendo ajudar ferramentas de desenvolvimento a consumir documentação técnica de forma mais barata, o que é bem diferente de conseguir que uma marca seja citada pelo ChatGPT numa resposta para o consumidor final.
O que já sabemos sobre 2026: quem está lendo o arquivo
É aqui que a conversa começa a virar dado de verdade!
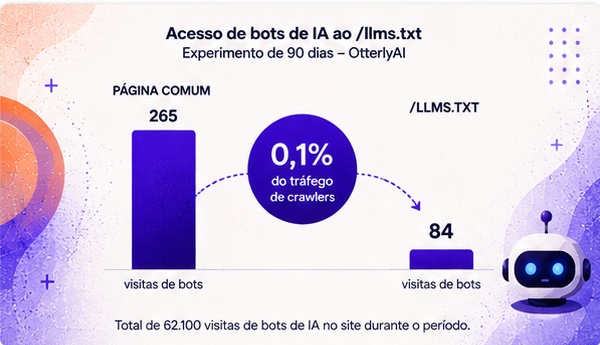
A OtterlyAI rodou um experimento de 90 dias monitorando logs de servidor de um site com llms.txt implementado corretamente. Das 62.100 visitas de bots de IA registradas no período, tivemos 84 que foram até o arquivo. Estamos falando de uma fatia de 0,1%. Para efeito de comparação, uma página comum do mesmo domínio recebeu em média 265 visitas de bots no mesmo intervalo: o llms.txt performou pior do que o conteúdo comum do site, próximo do nível de um PDF esquecido dentro de uma pasta de assets.
Em escala ainda maior, uma análise da SE Ranking sobre quase 300 mil domínios encontrou adoção de apenas 10,13%, número praticamente estável entre sites de tráfego baixo, médio e alto. Tem ainda outro ponto mais relevante do que a taxa de adoção: ao rodar um modelo de machine learning (XGBoost) para prever a frequência de citação de um domínio em respostas de IA, remover a variável “tem llms.txt” do modelo melhorou a precisão da previsão. O arquivo estava adicionando ruído aos dados, não sinal.
As declarações públicas de quem constrói os sistemas de busca com IA seguem na mesma direção. John Mueller, do Google, afirmou publicamente que nenhum sistema de IA usa o llms.txt hoje, comparando o arquivo à antiga meta tag de keywords, sinal controlado pelo próprio site e por isso descartado pelos buscadores há mais de uma década. Gary Illyes reforçou a mesma posição numa edição do Google Search Central Live.
Em dezembro de 2025, um llms.txt chegou a aparecer brevemente na documentação de desenvolvedores do próprio Google, e foi removido no mesmo dia, sem explicação oficial além de um comentário informal de Mueller nas redes sociais.
Por que empresas grandes ainda publicam o arquivo
Nem tudo é rejeição!
Existe um argumento a favor levantado pela Mintlify, plataforma de documentação usada por Anthropic, Cursor e Windsurf. A Anthropic pediu explicitamente à Mintlify para publicar llms.txt e llms-full.txt na própria documentação, o Google incluiu um arquivo llms.txt no protocolo Agent2Agent, e a Vercel relatou que 10% de seus novos cadastros vêm do ChatGPT, atribuindo parte do resultado a esforços de GEO de forma geral, não ao llms.txt isoladamente.
O que temos de real por trás desses exemplos é ainda mais estreito do que pode parecer. Cada caso está ligado a documentação técnica e integração de produto, exatamente o cenário para o qual o padrão foi desenhado, e não a conteúdo institucional ou de marketing tentando aparecer numa resposta do Gemini sobre “melhores fornecedores de X”.
O fato de a Anthropic ter um llms.txt em docs.anthropic.com não prova que o Claude, ao navegar a web em nome de um usuário, dê qualquer peso extra ao llms.txt de um site qualquer de e-commerce ou de uma empresa de serviços B2B.
O critério prático de decisão
Para a maioria das marcas que fazem SEO e GEO institucional, sem documentação técnica voltada a agentes de codificação, implementar llms.txt hoje não deveria ser prioridade. Não porque o arquivo cause algum prejuízo, ele não causa, mas porque o tempo do time técnico tem custo de oportunidade, e cada hora dedicada a manter um llms.txt é uma hora que deixou de ir para dados estruturados, arquitetura de conteúdo ou cobertura de entidades, itens com evidência real de impacto em citação por IA.
Existem cenários em que a resposta muda de figura. A tabela abaixo resume o critério de decisão por tipo de situação.
| Cenário | Vale a pena agora? | Por quê |
| Documentação técnica ou API consumida por agentes de codificação (Cursor, Claude Code, Windsurf) | Sim | É o caso de uso original do padrão: reduz tokens e fricção para ferramentas que já consultam sua documentação |
| Site já hospedado em plataforma de documentação com geração automática (Mintlify, GitBook, Docusaurus) | Sim, é quase de graça | O arquivo já é gerado sem trabalho manual recorrente da equipe técnica |
| Produto ou empresa que constrói integrações de IA dependentes de terceiros lendo o conteúdo do site | Vale testar | Reduz custo de processamento para quem integra, mesmo sem efeito comprovado em citação de busca |
| Marca institucional ou e-commerce buscando aparecer mais em respostas do ChatGPT, Gemini ou Perplexity para consumidor final | Não, ainda não há evidência | Estudos de 2025 e 2026 não encontraram correlação entre ter o arquivo e ser citado com mais frequência |
| Site pequeno ou com maturidade técnica baixa, sem dados estruturados nem arquitetura de conteúdo organizada | Não, priorize o básico primeiro | Dados estruturados, performance técnica e autoridade de conteúdo têm evidência real de impacto maior |
Como testar barato antes de investir mais
Se depois desse critério a resposta ainda for “talvez”, dá para testar sem comprometer o roadmap do time:
- Publique uma versão enxuta do arquivo, cobrindo só a home e as páginas mais estratégicas, no tempo de uma tarde de trabalho, sem reformular a arquitetura do site inteiro.
- Monitore o log do próprio servidor por 60 a 90 dias, filtrando user agents de bots de IA (GPTBot, ClaudeBot, PerplexityBot, Google-Extended) e comparando quantos acessos batem no /llms.txt contra o volume que bate nas páginas normais, no mesmo formato do teste feito pela OtterlyAI.
- Cruze esse dado com uma ferramenta de monitoramento de menções e citações em IA para ver se existe qualquer variação real na frequência com que a marca é citada no período.
- Se depois desse ciclo o arquivo seguir recebendo tráfego residual e nenhuma correlação com citações, arquive o projeto sem culpa e redirecione o esforço para o que já tem evidência de funcionar.
Esse teste custa uma fração do tempo normalmente gasto vendendo o llms.txt como entregável fixo de um contrato de GEO, e devolve ao time um dado real em vez de uma aposta.
Nossa posição
O llms.txt não é hype vazio! É uma ideia legítima resolvendo um problema real de infraestrutura para agentes que consultam documentação técnica.
O problema é o marketing que cresceu em cima dela, prometendo visibilidade em IA generativa que os próprios dados de 2026 ainda não confirmam. Para a maioria das marcas fora do universo de documentação para desenvolvedores, o melhor uso do tempo do time técnico continua sendo o básico que já tem evidência de funcionar: conteúdo estruturado, autoridade de conteúdo e monitoramento real de como a marca aparece, ou não aparece, dentro das respostas de IA. O llms.txt pode ficar na lista. Só não deveria furar a fila.
E aí, curtiu? Quer continuar acompanhando a gente?
👉 Volta aqui de vez em quando. Tem sempre conteúdo fresquinho sobre o universo de SEO e AI Search
👉 Segue a Wesearch no LinkedIn pra não perder nada.
👉 Tem dúvidas, sugestões, insights ou quer conhecer nosso trabalho e como podemos ajudar sua marca? Manda no [email protected]
Nosso modelo de consultoria parte da necessidade do cliente, por isso que nossos projetos não são engessados! Temos experiência que vai da indústria aos marketplaces, de fintechs ao turismo, de SaaS ao setor de infraestrutura e mobilidade. Isso nos permite ajudar você a dar um sentido real às mudanças no comportamento dos seus clientes. Vem falar com a gente.
Até a próxima!